
在1Panel AI一体机产品家族里,双卡方案处在一个微妙的位置:向上,四卡/八卡方案能力更强但预算翻倍;向下,单卡方案便宜但可选模型有限。很多客户在考察了多种方案之后,想要更大尺寸的模型,同时也想知道双卡方案在实际的业务场景中是否够用。
这个问题无法通过参数表回答。参数表告诉你显存多大、算力多少,但不会告诉你:10人并发会不会卡?一份8万字的代码库丢进去要等多久?这些只有压测数据能够回答。近期,我们在2张NVIDIA RTX Pro 5000 Blackwell 72GB加速卡上完成了Qwen3.8-Flash-Next模型的压力测试,聚焦WorkBuddy办公场景,经过生产环境为期一周的测试和使用,获得了企业用户关心的一手数据。
一、双卡是部署Qwen3.8-Flash-Next的高性价比方案
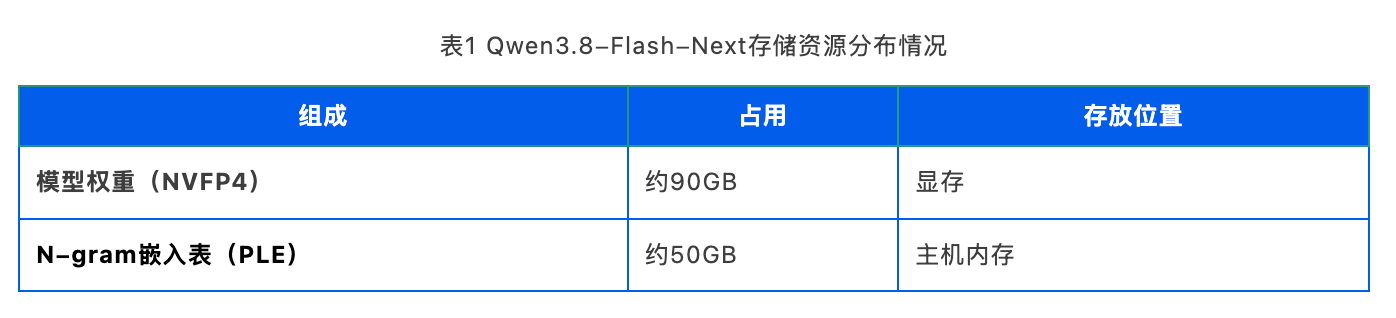
模型方面,Qwen3.8-Flash-Next是阿里千问面向智能体(Agent)场景打造的效率型模型。作为Qwen4架构预览版MoE大模型,Qwen3.8-Flash-Next的总参数为125B,单Token仅激活6B。模型搭配51B独立N‑gram Embedding查表权重,N‑gram层可以卸载至内存,几乎不增加算力,强化短语表征。该模型原生262K上下文,可扩展至1M Token。
在Artificial Analysis的Agentic real-world work tasks评测中,Qwen3.8-Flash-Next表现亮眼:它在真实工作任务的完成度和稳定性上,与体量大得多的模型处在同一梯队,但参数量与显存占用却低得多。这意味着该款模型对硬件配置的要求更低,可以支撑更高并发,同时降低单次推理成本。Qwen3.8-Flash-Next是目前1Panel AI一体机产品线中,最适配AI办公/AI编程场景的模型之一。
硬件方面,单卡是入场券,四卡是旗舰,而双卡恰好处在性价比的拐点上:
■ 显存够用:2张卡提供144GB总显存,完整承载Qwen3.8-Flash-Next的模型权重,同时为KV Cache和并发调度留出充足余量;
■ 算力翻倍:相较单卡方案,张量并行(TP=2)让可用算力近乎翻倍,直接体现在首字延时和整机吞吐上;
■ 成本可控:一次硬件投入,覆盖一个部门级团队(几十人规模)的日常AI用量,边际调用成本趋近于零;
■ 扩展平滑:双卡配置向上可平滑扩展至四卡集群,系统构建无需推倒重来。
二、部署环境与测试口径
1Panel AI一体机(方案3)的软硬件配置与部署参数如下:
■ CPU:2颗Intel Xeon Silver 4510
■ 内存:128GB
■ 加速卡:2张NVIDIA RTX Pro 5000 Blackwell 72GB
■ 推理引擎:vLLM
■ 推理镜像:vllm/vllm-openai:qwen38-flash-next
■ 管理软件:1Panel企业版
部署方案解读:
■ 双卡提供144GB总显存,承载模型权重后仍有充足的KV Cache空间,这是支撑高并发的物理基础;
■ NVIDIA RTX Pro 5000 Blackwell支持ECC大显存,适合企业内部长期无人值守运行;
■ vLLM推理引擎提供高性能推理服务与标准OpenAI兼容接口,开箱即用;
■ 1Panel企业版统一管理模型、资源和应用,是统一的运维与管理平台。
核心指标定义:
■ TTFT:发出提问到模型吐出第一个字的等待时间,直接决定用户体感;
■ TPOT:生成每个Token所需的平均时长;
■ 输出吞吐TPS(tokens/s):每秒生成的Token数,分“整机”(整机输出吞吐TPS)和“单路”(人均输出吞吐TPS)两个子指标;
■ 端到端吞吐(E2E TPS):把输入处理也算进去的整体处理速度,长输入场景下更接近于真实负载。
三、方案性能实测
1. 压力测试数据分析
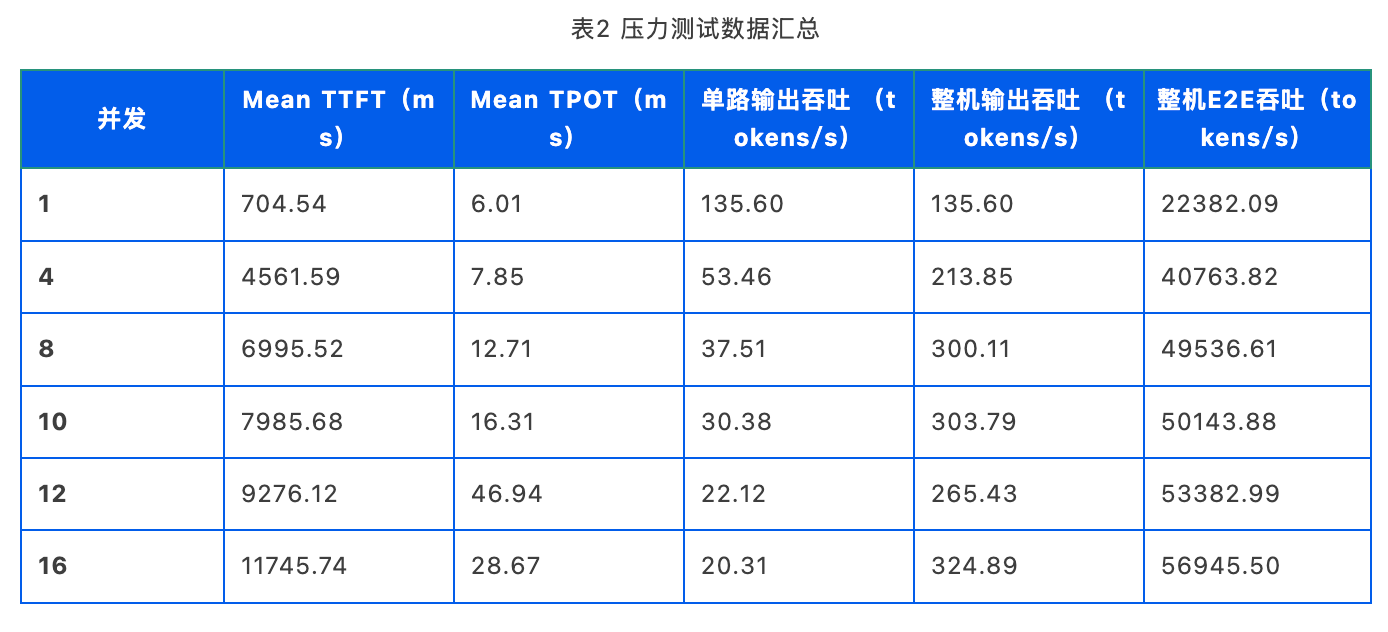
基于双卡部署Qwen3.8-Flash-Next模型方案的压力测试模拟WorkBuddy办公智能体真实负载:输入84k Tokens、输出0.5k Tokens,Prefix Cache命中率为90%。
压测数据解读:
■ 首字延时(TTFT,单位:毫秒):发出提问到模型吐出第一个字的等待时间,直接决定用户的体验感。1并发时TTFT仅704ms,低并发下体验优秀,随着并发的提升,TTFT逐步上涨,10并发时TTFT接近8s;
■ 整机输出吞吐(TPS,单位:tokens/s):整机输出吞吐TPS表征模型整体的Token生成处理能力。并发从1提升至10,整机输出TPS稳步上升,10并发时达到303.79 tokens/s;继续抬至16并发,硬件被进一步压榨,整机输出TPS冲高至324.89 tokens/s,更高的整机吞吐是以牺牲时延体验为代价的;
■ 单路输出吞吐(TPS,单位:tokens/s):单路输出TPS即单会话输出Token速率,对应每一个用户实际感受到的文本输出速度。单并发状态下独享GPU算力,人均TPS可达135.60 tokens/s。随着并发数的增加,分配给每个会话的算力被稀释,人均TPS呈持续下降趋势。并发10时人均TPS为30.38 tokens/s,办公智能体场景仍处于可接受区间。并发超过12之后,人均TPS降至20‑22 tokens/s区间,单用户文本生成速度明显变慢,交互体验下滑。
2. 生产环境实测数据分析
本次压测数据反映的是模型服务的极限性能,真实生产环境的实际表现,还会受KV‑Cache、Prefix Cache命中率波动、请求上下文长度分布、后端调度开销等多重因素的影响。我们把1Panel AI一体机(方案3)接入WorkBuddy,在飞致云生产环境中承担AI办公为主的负载,经过为期一周的持续验证,在使用WorkBuddy真实办公的6并发场景下,Qwen3.8-Flash-Next模型的实测数据如下:
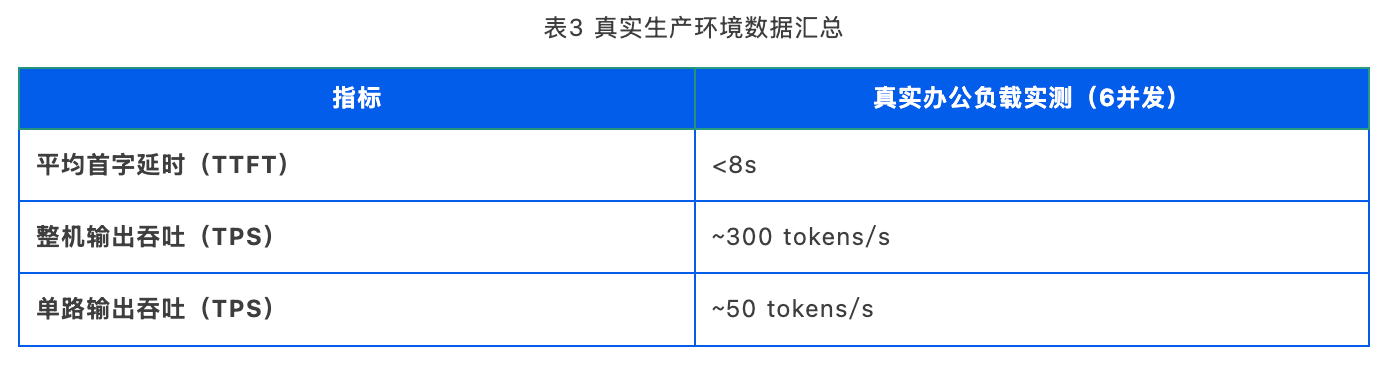
注:以上数据基于真实办公环境生产环境调用大模型监控数据得出。
在实际使用中,WorkBuddy依托约91%的前缀缓存命中率,显著提升了超长上下文首字延时和端到端吞吐表现。得益于MTP投机解码加速,真实的整机输出吞吐会高于压力测试的结果。在6人同时使用的AI办公场景下,每个人仍能获得相当于正常阅读速度约2倍的输出体验,完全能够满足企业日常AI办公的流畅度要求。
四、选型建议
基于上述数据,以下选型建议可以作为企业用户实际选型的参考:
推荐选择双卡方案(方案3)的场景:
■ 部门级AI办公团队:几十人规模,日常办公场景以问答、文档处理、代码辅助为主;
■ Agent智能体/AI Coding重度用户:需要把8万Tokens级别的代码库和工程上下文交给模型处理;
■ 数据敏感型业务部门:法务、财务、经营分析等办公场景,内部资料严格不能出域;
■ 希望锁定长期成本的团队:一次性硬件投入,后续边际调用成本趋近于零。
建议升级扩展至四卡方案的场景:
■ 并发需求持续超过10:此时人均Token生成速度已明显下滑,单用户体验衰减明显,单纯拉高并发换取整机吞吐性价比低;
■ 超长上下文Agent任务且并发要求高:84K上下文场景稳定并发上限在6~8区间,更高并发需要扩容;
■ 追求推理能力上限:Qwen3.8-Flash-Next是效率型选手,超高难度推理及超长链路复杂任务建议选用旗舰模型;
■ 单机同时部署多个模型:双卡144GB显存会被单个大模型占满,需要扩容。
如果业务需求是动态的,最优方案不是把并发开到极限,而是用1Panel AI网关做智能路由:高频办公流量交给本地双卡一体机,个别复杂任务调度至本地旗舰模型或云端API。这样一来,既锁定了成本下限,也能保住能力上限。
五、总结
实验室里的峰值性能只能证明模型“能跑”,只有生产环境连续运行过的数据,才能证明方案“敢用‘。我们通过压力测试摸到双卡的能力上限,再把1Panel AI一体机(方案3)接入WorkBuddy,在飞致云真实生产环境中以AI办公负载为主连续运行一周时间,获取了真实的生产环境数据。上限数据与真实数据相互印证,这一方案才算真正可行,具备企业落地的实际价值。
“双卡RTX Pro 5000 Blackwell+Qwen3.8-Flash-Next”的组合,在生产环境中证明了它作为1Panel AI一体机“黄金档”方案的价值:算力自由不再是旗舰机型的专属。两张卡、一个部门、一台一体机,是中型企业私有化AI落地更务实的答案。