
当企业开始将大模型应用于AI编程、Agent(智能体)等复杂任务时,模型的价值不再局限于回答问题或生成内容,而是进一步延伸至代码理解、项目开发、工具调用和多步骤任务执行。与此同时,这类高阶应用也对底层推理基础设施提出了更高要求。单次请求的上下文规模可能达到数万甚至十万Tokens,多轮任务执行过程中还会反复使用大量相同的历史信息。
对于企业而言,选择一个具备优秀编程和Agent能力的模型只是第一步。如何在企业本地部署大模型并保障长上下文、多轮交互和多用户并发下的推理体验,同样重要。
2026年10月,DeepSeek发布了DeepSeek-V4.1-Flash-1017模型,进一步强化了AI编程和Agent能力。近期,飞致云基于1Panel AI一体机(方案六),采用8张NVIDIA RTX Pro 5000 Blackwell 72GB加速卡,完成了DeepSeek-V4.1-Flash-1017模型的企业私有化部署,并且针对AI编程、Agent、复杂任务和常规对话等工作负载开展性能测试。
本文将重点围绕AI编程与Agent场景,结合模型能力基准、实际部署配置和多并发压测数据,分析该方案在企业本地环境中的推理表现与应用价值。
一、DeepSeek-V4.1-Flash-1017简介
DeepSeek-V4.1-Flash-1017模型延续了DeepSeek-V4.1-Flash的高效稀疏MoE架构,在保持较低单Token计算开销的同时,进一步强化了代码生成、工具调用、复杂推理和长链路任务执行能力。从企业应用的角度来看,这一模型的价值不仅在于能够回答更加复杂的问题,更在于它能够作为智能体的核心推理引擎,参与多个步骤连续执行的实际业务流程。DeepSeek-V4.1-Flash-1017模型的主要技术特点如下:
■ 大规模稀疏MoE架构:总参数规模约552B,通过稀疏专家激活机制控制单Token计算量,在模型能力与推理效率之间取得平衡;
■ 百万Token上下文:支持约1M Token上下文窗口,为大型代码仓库分析、超长文档理解和复杂智能体任务提供基础;
■ 编程与智能体能力增强:进一步改善代码生成、工具调用和多步骤任务执行表现,适用于企业内部研发与业务自动化场景;
■ 长上下文处理能力:能够在单次请求中接收更大规模的上下文信息,减少复杂任务中反复截断、拆分和拼接内容的需求;
■ 推理效率优化:通过模型架构、缓存和推理策略优化,为企业构建高性能的本地AI服务提供条件。
二、1Panel AI一体机8卡私有化部署方案
2026年7月,飞致云发布了1Panel AI一体机产品家族。这一产品系列采用类“超融合”的产品理念,将底层计算资源、模型服务和AI应用进行整合,为企业提供开箱即用的私有化AI基础设施。
与需要自行采购服务器、配置GPU环境、适配推理框架和建设应用平台的传统方式相比,1Panel AI一体机为用户交付经过验证的软硬件组合,有效降低企业构建本地AI服务的工程复杂度。
本次测试是在1Panel AI一体机(方案六,8卡服务器版)上部署DeepSeek-V4.1-Flash-1017模型,通过真实环境测试新款模型在企业级应用场景中的实际性能表现。
硬件参数
■ 机头:4U机架式服务器
■ CPU:2颗Intel Xeon Gold 6530
■ 内存:512GB
■ 存储:4TB SSD
■ 加速卡:8张NVIDIA RTX Pro 5000 Blackwell 72GB
■ 模型:DeepSeek-V4.1-Flash-1017
■ 推理引擎:vLLM
■ 模型精度:官方原生FP4+FP8混合精度
■ KV Cache精度:FP8
■ 并行策略:TP8+EP8
■ 上下文窗口:1M
■ 投机解码:DSpark K5
■ Engram:主机内存
内置软件
■ 1Panel企业版:1Panel企业版是专门面向AI服务器打造的管理面板,打通从GPU管理、模型准备、模型部署、模型服务、基准测试到对外提供Token服务的全流程闭环;
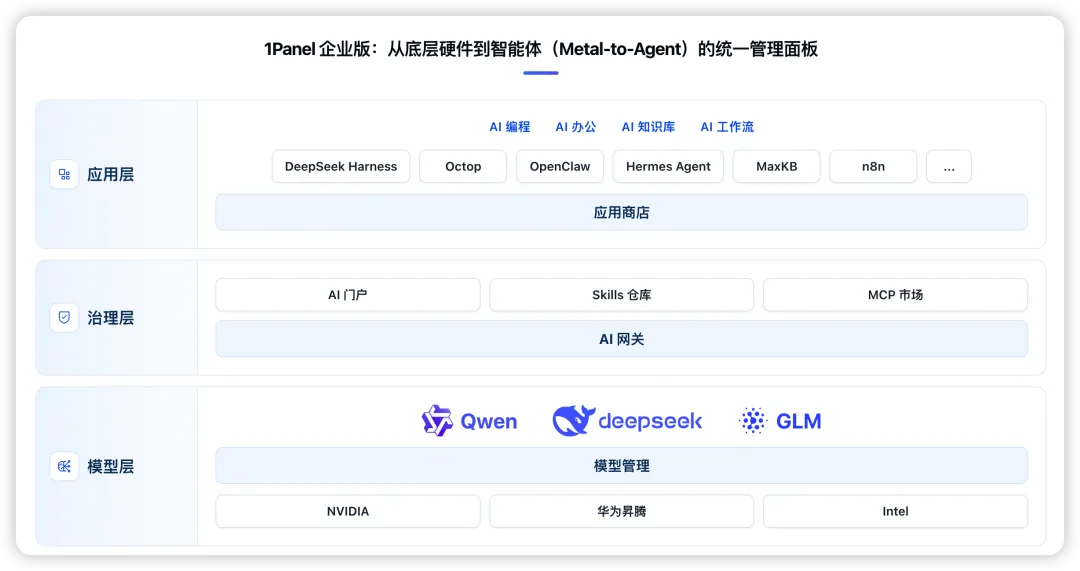
▲图1 1Panel企业版产品架构
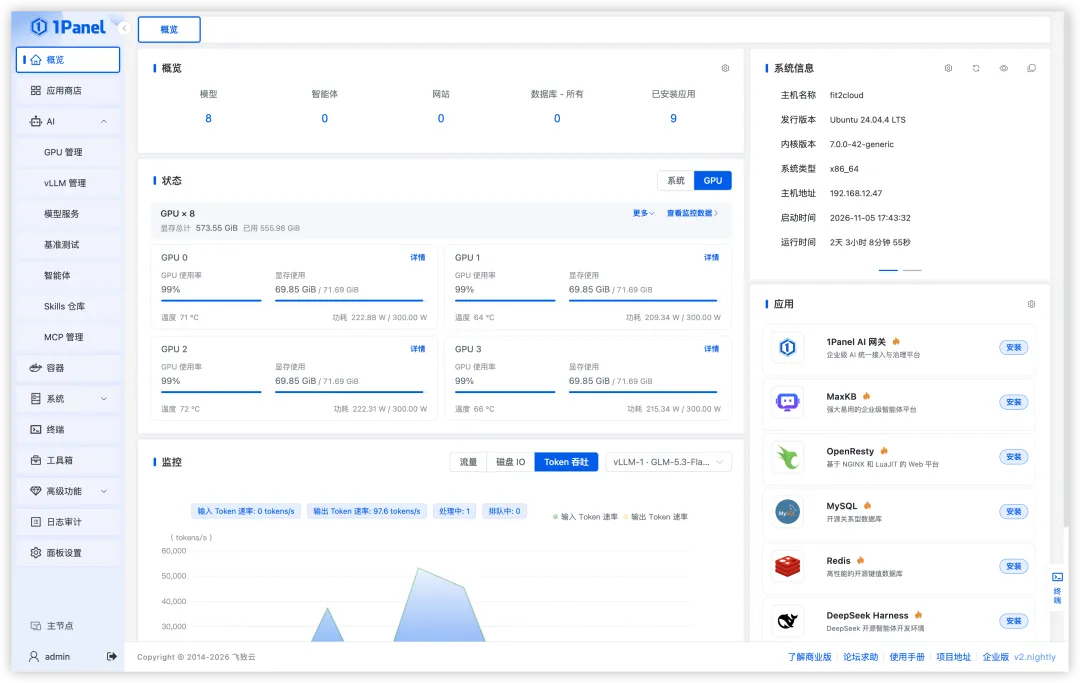
▲图2 1Panel企业版概览页
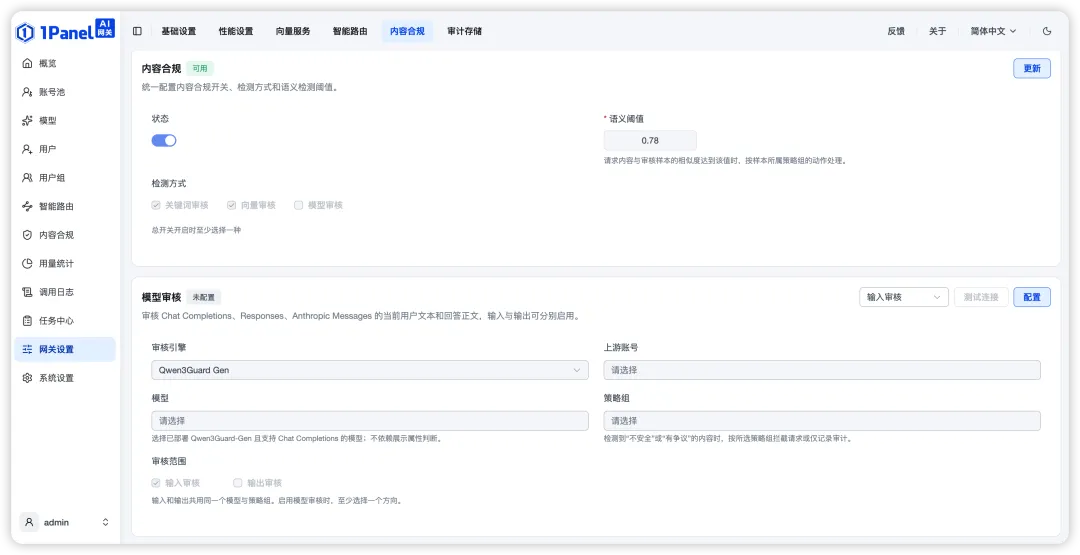
▲图3 1Panel AI网关控制台
■ MaxKB企业版:MaxKB是开源企业级智能体平台,致力于解决企业AI落地面临的技术门槛高、部署成本高、迭代周期长等问题。
三、DeepSeek-V4.1-Flash-1017性能实测
对于企业私有化部署而言,大模型的实际应用价值不仅取决于模型能力,还取决于其在不同业务负载下的推理性能。尤其是在多用户并发、长上下文处理等场景中,模型的响应速度和吞吐能力将直接影响业务系统的使用体验。本次测试基于1Panel AI一体机(方案六),围绕企业常见的AI应用负载,将测试场景划分为以下两类:
■ 通用业务场景:包括短对话、长文档总结/RAG(检索增强生成),以及通用复杂任务,覆盖日常办公助手、企业知识库、文档分析等应用;
■ AI编程/Agent场景:重点模拟大型代码仓库分析、多轮工具调用和复杂智能体任务,考察模型在超长上下文及高前缀缓存命中率条件下的推理表现。
两类场景均从首字延时(TTFT)、整机输出吞吐和单路输出吞吐三个维度进行分析,分别反映模型的首字响应速度、服务器整体推理产能,以及单个用户能够获得的实际文本生成速度。
1. 通用业务场景
通用业务场景覆盖企业AI助手、知识库问答、文档总结及复杂问题分析等任务,分别设置三组测试负载:
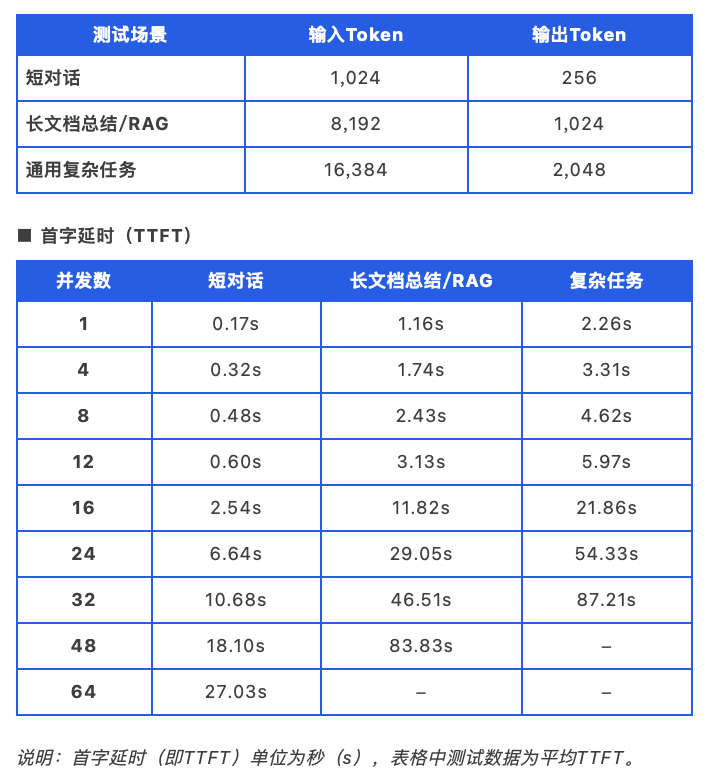
在短对话场景下,单并发平均首字延时仅173ms,12并发时仍控制在0.60秒左右,具备较好的交互响应能力。随着输入长度及并发增加,首字延时逐步上升。尤其从12并发提升至16并发时,三类场景均出现明显的延时增长,表明系统逐渐进入资源竞争和请求排队更为明显的运行区间。
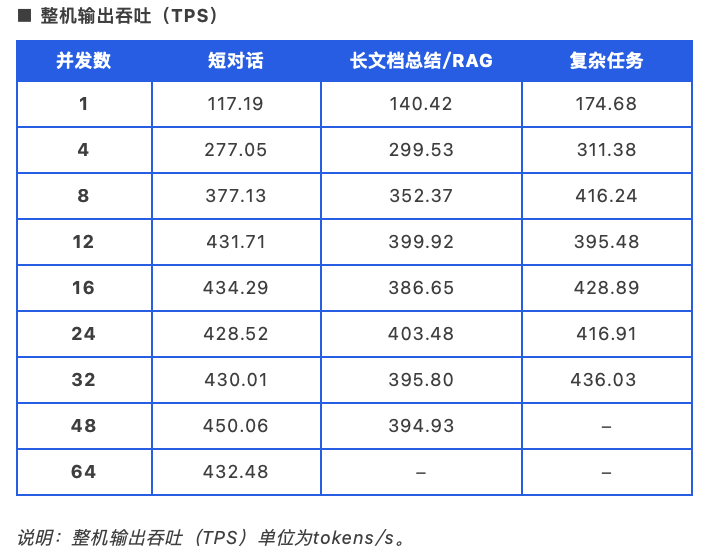
在低并发阶段,增加并发能够显著提升整机输出能力。以短对话场景为例,整机输出吞吐从单并发的117.19 tokens/s提升至12并发的431.71 tokens/s,约为单并发的3.68倍。
当并发进一步提高至24、48乃至64时,短对话场景的整机吞吐基本维持在430–450 tokens/s附近,未随并发数量持续增长。RAG和复杂任务场景也呈现类似趋势,整体输出吞吐在较高并发下逐步进入平台期。测试数据表明系统的生成产能已接近当前配置下的有效上限,继续增加并发带来的收益有限。
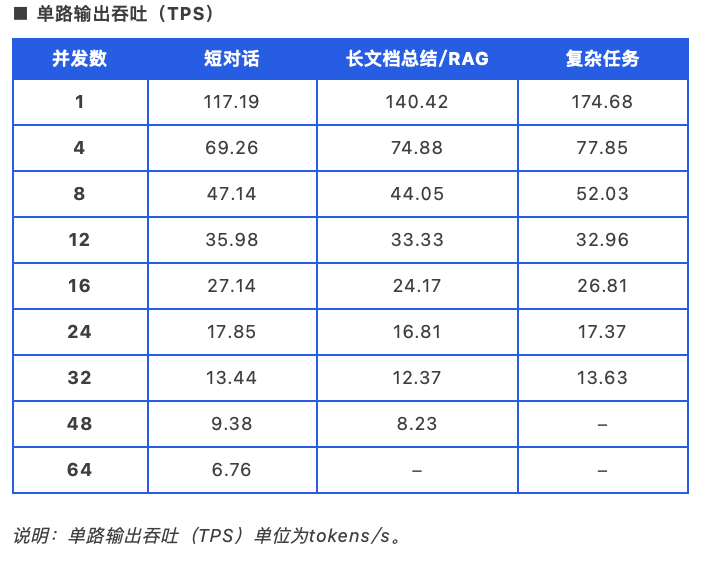
单并发条件下,三类场景的单路输出吞吐达到117–175 tokens/s,能够提供较快的文本生成体验。随着并发的增加,单路生成速度逐步下降。在8–12并发区间,三类场景的单路输出吞吐约为33–52 tokens/s。这一结果表明,虽然高并发能够提高GPU的资源利用率,但在整机吞吐进入平台期后,继续增加并发会显著降低单个用户的Token生成速度。
2. AI编程/Agent场景
AI编程和Agent场景通常涉及代码仓库分析、多轮工具调用及复杂任务执行,具有上下文长、重复内容多、多轮交互频繁等特点。本次测试分别设置64K和84K输入、1K输出,并且采用90% Prefix Cache命中率,模拟智能体任务中的上下文复用场景。
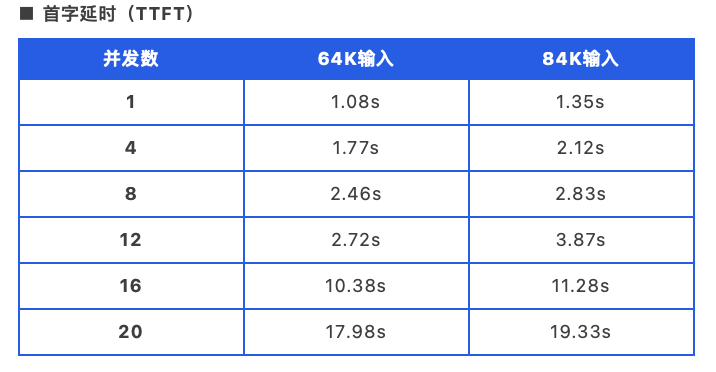
在90%前缀缓存命中率条件下,即使输入达到64K–84K Tokens,单并发平均首字延时仍控制在1.08–1.35秒,12并发时首字延时分别为2.72秒和3.87秒。Prefix Cache能够有效减少重复上下文计算,改善长上下文任务的响应效率。但当并发超过12后,首字延时明显增加。
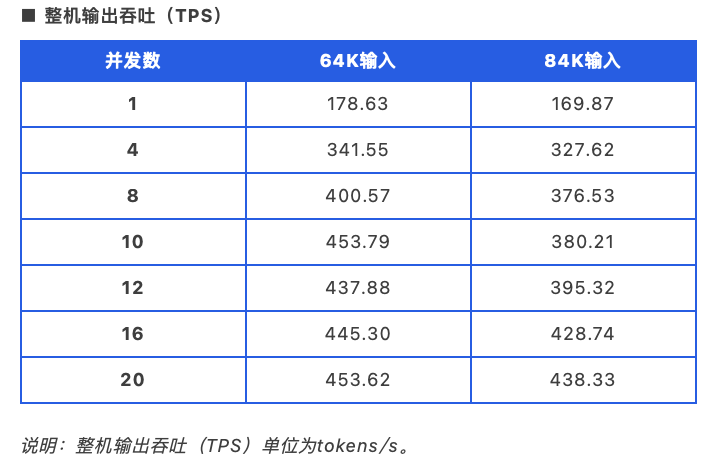
在64K场景下,10并发整机输出吞吐达到453.79 tokens/s;84K场景下,20并发时整机输出吞吐达到438.33 tokens/s。由此可见,在较高缓存命中率条件下,超长上下文负载仍能够获得较好的整机输出能力。不过,随着吞吐逐步进入平台期,继续提高并发会明显增加首字等待时间。
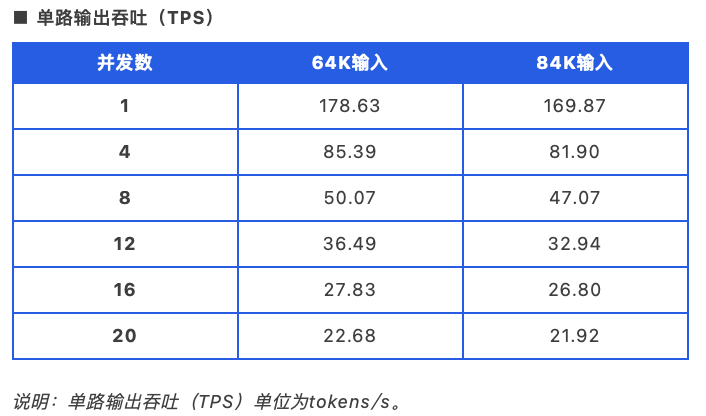
单路输出吞吐兼顾复杂任务的持续生成效率。在单并发条件下,64K输入和84K输入场景的输出速度分别达到178.63 tokens/s和169.87 tokens/s;8并发时仍保持约47–50 tokens/s,能够为代码生成和智能体任务提供较快的持续输出能力。随着并发的增加,单路输出速度逐渐降低。
结合首字延时与整机吞吐表现,8–12并发可作为此类高缓存命中负载的重点容量评估区间。
四、测试总结
本次实机测试表明,配备了8张NVIDIA RTX PRO 5000 Blackwell 72GB加速卡的1Panel AI一体机(方案六),能够为DeepSeek-V4.1-Flash-1017模型提供较好的本地推理能力。
■ 在通用业务场景下,短对话单并发平均首字延时仅为0.17s,多并发整机输出吞吐可达到约400–450 tokens/s;
■ 在AI编程/Agent场景下,通过前缀缓存复用,64K–84K超长上下文同样能够保持较好的响应和生成性能,多并发整机输出吞吐仍可超过400 tokens/s,10并发时,单路输出吞吐可达到40 token/s左右,16并发时单路输出吞吐仍可达较为流畅的27 tokens/s,实际部署时建议采纳10~16并发。
本次测试也表明,更高的并发并不意味着更好的使用体验,不同业务建议采用不同的并发策略。当整机吞吐逐渐达到平台期后,首字延时和单路输出速度可能明显恶化。因此,企业在实际部署时,应该根据业务对响应速度、上下文长度和吞吐能力的不同要求,合理规划并发容量,充分发挥8卡方案的推理性能。
五、结语
DeepSeek-V4.1-Flash-1017的发布,为企业私有化部署高能力大模型提供了新的选择。但对于企业用户而言,衡量一款模型是否适合生产应用,既要关注其在第三方评测中的能力表现,也要通过实际部署验证硬件资源消耗、并发吞吐、响应延时,以及不同业务场景下的运行表现。企业私有化AI的价值,并不只是让大模型在本地运行,而是通过合理的软硬件选型、推理优化和资源治理,使模型能力真正转化为可持续交付的业务服务。
1Panel AI一体机以“超融合”理念整合经过适配的算力、推理引擎、AI服务器管理面板、AI网关和AI应用等,有效降低本地私有大模型部署和Token运营的复杂度,帮助用户构建安全、可控、易管理的本地AI Token工厂服务系统。未来,飞致云也将持续围绕主流开源大模型开展软硬件适配和性能验证,为企业提供更多经过实际测试的私有化AI部署一体机方案。